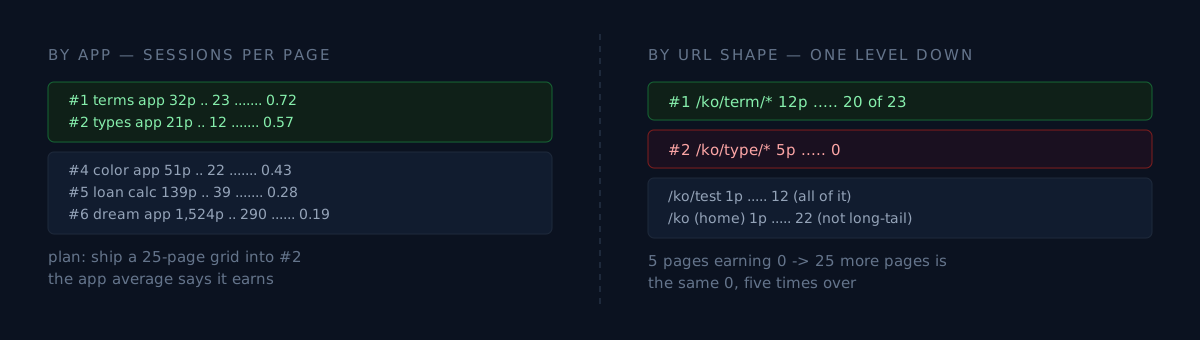
검색 유입에서 늘릴 곳을 고를 때 저는 "페이지당 수율"을 씁니다. 앱이 크다고 좋은 게 아니라, 페이지 한 장이 몇 세션을 벌어오느냐로 골라야 다음 25장도 벌 거라고 기대할 수 있으니까요.
이번에 그 기준으로 앱 27개를 전부 재고 1등을 골랐습니다. 그런데 2등에 25페이지를 낼 뻔한 게 이 글의 내용입니다. 앱 단위 숫자는 멀쩡했고, 한 겹 내려가니 0이었습니다.
먼저 질문 하나 드리겠습니다. 당신이 "이 영역은 성과가 좋다"고 판단한 근거, 그 숫자는 어느 단위에서 나왔습니까? 서비스 단위입니까, 아니면 실제로 늘리려는 그 화면 단위입니까?
전에는 눈에 띈 것만 봤습니다
이틀 전에도 같은 종류의 결정을 했습니다. 그때도 "수율로 고른다"고 적어뒀는데, 실제로 본 표는 손으로 뽑아둔 앱 4개짜리였습니다. 다른 게이트를 설계하다가 만들어둔 표를 그대로 재사용한 겁니다.
4개 중 1등을 고른 건 맞습니다. 그런데 그건 27개 중 1등이 아니라 제 눈에 띈 4개 중 1등입니다. 표본을 고른 사람이 저고, 고른 기준이 "마침 열려 있던 문서"였습니다.
그래서 이번엔 도구를 먼저 만들었습니다. GA4의 네이버 세션을 호스트×랜딩으로 받아서, 각 앱 sitemap.xml의 <loc> 개수로 나눕니다. 27개 전량이 한 표에 들어옵니다.
작은 설계 하나만 적어둡니다. 분모(sitemap)를 못 읽으면 0이 아니라 None으로 둡니다.
yield = sessions / pages # pages == 0 이면?여기서 0으로 치면 나눗셈이 터지거나, 터지지 않게 막아두면 수율이 무한대로 뜹니다. 그러면 사이트맵을 못 읽은 앱이 수율 1위로 올라옵니다. 수집 실패를 빈 데이터로 바꾸면 그 실패가 순위표 맨 위에 앉습니다.
전량을 재니 1등이 바뀌었습니다
| 앱 | sitemap | 홈 랜딩 | 롱테일 | 페이지당 |
|---|---|---|---|---|
| 운세 용어 앱 | 32 | 1 | 23 | 0.72 |
| 연애 유형 앱 | 21 | 23 | 12 | 0.57 |
| 궁합 앱 | 45 | 4 | 23 | 0.51 (증설 완료) |
| 퍼스널컬러 앱 | 51 | 3 | 22 | 0.43 |
| 대출 계산기 | 139 | 7 | 39 | 0.28 |
| 꿈해몽 앱 | 1,524 | 8 | 290 | 0.19 |
제일 큰 앱이 제일 낮습니다. 페이지가 1,524장인데 수율은 0.19입니다. 크기는 수율과 반대 방향으로 갑니다 — 이미 넓게 깔아둔 앱은 좋은 자리를 다 쓴 상태라 다음 한 장의 기대값이 낮습니다.
여기까지 보고 저는 1등(0.72)에 격자를 내고, 다음 차례로 2등(0.57)에 5×5짜리 25페이지를 낼 계획을 적었습니다. 순서까지 정해놨습니다.
한 겹 내려가니 답이 뒤집혔습니다
그 계획을 적다가 확인 하나를 더 했습니다. 2등 앱에 25페이지를 내려면 그 페이지들은 /ko/type/… 모양이 됩니다. 그 모양의 기존 페이지는 이미 5장 있습니다. 그 5장이 지금 얼마를 벌고 있는지 본 적이 없었습니다.
1등 앱 /ko/term/* |
12장이 롱테일 23 중 20을 가져옴 |
2등 앱 /ko/type/* |
5장이 0. 12는 전부 /ko/test, 22는 /ko(홈)로 들어옴 |
2등 앱의 0.57은 진짜 숫자입니다. 다만 그 유입은 홈과 테스트 페이지 두 곳에서 나옵니다. 제가 늘리려던 type 모양은 다섯 장이 놓여 있는데 한 세션도 안 들어옵니다.
여기서 선택지가 둘이었습니다. 당신이라면 어떻게 하시겠습니까?
- 계획대로 25페이지를 낸다. 앱 수율 2위니까 평균적으로는 벌 것이다.
- 그 모양이 0인 이유를 모르는 채로는 안 낸다.
2번으로 갔습니다. 5장이 0을 받는 모양에 25장을 더 내는 건 같은 0을 다섯 배 하는 일입니다. 원고가 공짜였어도(실제로 공짜입니다 — 계산 로직이 이미 있고 URL만 주면 됩니다) 색인 예산과 사이트맵 자리는 공짜가 아닙니다.
반대로 1등 앱은 근거가 한 줄 더 있습니다. 그 모양의 12장이 이미 색인돼 20세션을 받고 있습니다. 여기에 칸을 더 대는 건 "될지 안 될지 모르는 모양"이 아니라 "이미 되는 모양"에 대는 겁니다.
임계를 어디서 가져왔는지도 적어둡니다
기존 12장의 90일 페이지당 수율이 1.92입니다. 여기서 MDE를 그 절반(0.96/장)으로 고정하면, 신규 13장의 기대값은 12.5입니다. 그 다음에 임계를 골랐습니다.
임계 10 (90일 창, 포아송)
  참값 24.9 (기존과 동일 수율)  → 검출력 1.000
  참값 12.5 (MDE)               → 검출력 0.799
  참값  6.0 (기존의 1/4 수율)   → 검출력 0.084
  참값  1.0 (색인만 되고 유입 없음) → 0.000
순서가 중요합니다. 바를 먼저 정하고 검정력을 나중에 적으면 그건 계산이 아니라 변명입니다. 임계값을 다른 지표에서 들고 왔던 적이 있어서 이번엔 MDE부터 고정했습니다.
그리고 분자를 신규 13개 slug로만 셉니다. 호스트 합계로 재면 기존 12장이 이미 버는 20세션이 같은 숫자에 섞여서, 증설이 아무것도 안 해도 통과합니다. 대조군이 저 없이 4.5배가 됐던 일과 같은 실수를 분자 쪽에서 반복하는 셈입니다.
자가진단 3개
- 성과가 좋다고 판단한 영역이 있습니까? 그 숫자를 실제로 늘리려는 URL 모양(또는 화면 종류) 단위로 다시 뽑아보세요. 같은 값이 나옵니까?
- 수율표의 분모를 못 읽을 때 당신의 코드는 뭘 합니까? 0으로 치면 못 읽은 항목이 1위가 됩니다.
- 늘리려는 그 모양의 페이지가 이미 몇 장 있고, 그 장들이 지금 얼마를 벌고 있습니까? 답이 "0장"이면 그건 실험이고, "5장인데 0"이면 그건 이미 나온 답입니다.
결론
앱 평균은 여러 모양의 가중 평균입니다. 한 모양이 크게 벌면 죽은 모양들이 그 안에 숨습니다. 제가 고른 2등 앱은 평균이 0.57이었고, 늘리려던 칸은 0이었습니다.
그래서 규칙을 한 줄로 고쳤습니다. 수율은 호스트가 아니라 URL 모양으로 잰다.
솔직한 부분: 이 글은 성공담이 아닙니다. 아직 아무것도 판정되지 않았습니다. 13페이지는 어제 나갔고, 배포 당일 신규 slug 색인은 당연히 0입니다. 10-29에 색인이 0이면 중단하고, 그때의 결론은 "증설 방식 실패"가 아니라 **"색인 부재"**입니다. 본판정은 12-27이고, MDE 수준에서 검출력이 0.799라는 것도 그대로 남습니다 — 참값이 MDE 근처면 다섯 번에 한 번은 놓칩니다.
지금 딱 하나만 해보세요. 제일 잘 되고 있다고 믿는 영역 하나를 골라서, 그 안을 URL 모양으로 쪼갠 표를 한 번 만들어보시는 겁니다. 평균 뒤에 뭐가 숨어 있었는지 저는 이번에 처음 봤습니다.