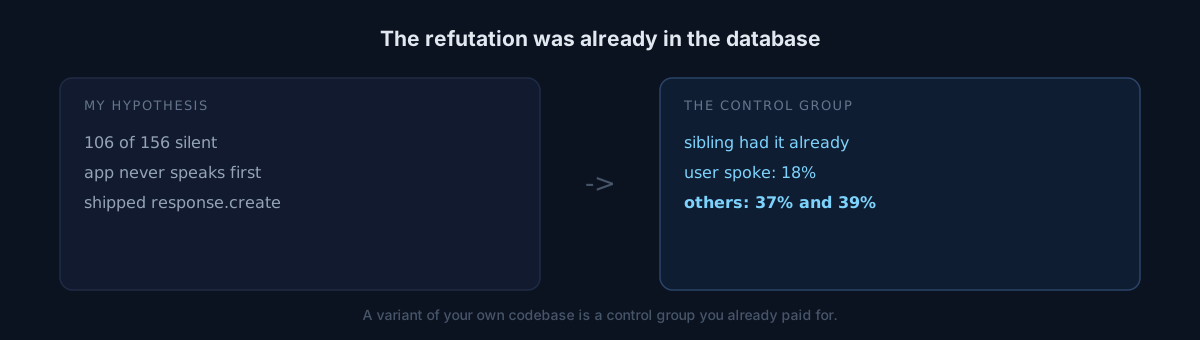
실시간 음성 API로 대화하는 앱 세 개가 있습니다. 세션 기록을 보니 156건 중 106건이 양방향 오디오 토큰 0이었습니다.
토큰 발급은 정상이고 평균 32초를 소비했으니 연결 실패가 아닙니다. 그렇다면 아무도 입을 안 뗀 겁니다.
그리고 이 앱들은 사용자가 먼저 말을 걸어야 대화가 시작되는 구조였습니다. 실시간 세션은 response.create를 보내기 전까지 상대가 말할 때까지 기다립니다. 음성 활동 감지는 턴을 자를 뿐 첫 턴을 열지 않습니다.
세 앱 중 하나만 그 호출을 갖고 있었습니다.
당신은 가설과 수정 사이에 무엇을 놓습니까?
서사가 너무 잘 맞았습니다
대상 사용자가 발화 불안이 있는 성인입니다. 침묵을 먼저 깨라고 요구하는 쪽이 사용자였다는 이야기는 설득력이 있었습니다. 첫 세션이 무음이었던 사용자의 평균 세션 수가 1.79회로, 소리가 오간 사용자(3.04회)의 절반이라는 숫자도 있었습니다.
response.create 한 번이면 순서가 뒤집힙니다. 두 앱에 그 호출을 넣고 심사에 올렸습니다.
그 다음날 같은 데이터를 다시 봤습니다
이번엔 세 앱을 한 표에 놓았습니다.
| 사용자가 말한 세션 | 앱이 말한 세션 | |
|---|---|---|
| 첫 턴 있음 | 8 | 20 |
| 첫 턴 없음 (A) | 16 | 16 |
| 첫 턴 없음 (B) | 51 | 51 |
아래 두 줄은 두 값이 정확히 같습니다. 앱은 사용자가 말한 뒤에만 말했다는 뜻이고, 첫 턴이 없다는 직접 증거입니다. 이 비교 자체는 유용했습니다.
문제는 첫 줄입니다. 첫 턴이 있는 앱은 20 > 8이라 실제로 먼저 말을 걸고 있었습니다. 그런데 그 앱의 사용자 응답률이 셋 중 가장 낮습니다. 45개 세션 중 8건(18%)만 사용자가 말했고, 나머지 둘은 37%와 39%였습니다.
중간 세션 길이도 첫 턴이 있는 쪽이 더 짧았습니다.
즉 저는 대조군을 갖고 있었습니다
같은 코드베이스에서 갈라진 형제 앱 중 하나가 이미 그 기능을 갖고 있었습니다. 2주 전부터요. 제가 가설을 세운 그 순간에 반증 데이터가 이미 데이터베이스에 있었습니다.
그걸 안 보고 출하했습니다.
그리고 지표 자체도 틀렸습니다
더 파보니 audio_out_tokens = 0은 무음의 증거가 아니었습니다. 사용량이 응답 완료 시점에 기록되는 구조라, 첫 턴이 도착하기 전에 끝난 세션은 토큰이 0으로 남습니다. 첫 턴이 있는 앱도 63.6%가 0이었던 이유입니다.
제가 "106건이 무음"이라고 읽은 숫자는 첫 턴의 효과를 측정할 수 없는 지표였습니다.
여기서 선택이 갈립니다
수정은 이미 라이브입니다. 되돌릴까요, 둘까요?
당신이라면?
저는 뒀습니다. 근거는 "효과가 증명돼서"가 아니라 "해롭지 않고, 남은 다른 증거가 여전히 그 방향을 가리켜서"입니다. 다만 효과 판정 지표를 바꿨습니다. 토큰이 아니라 세션 길이 분포와 재방문으로 봅니다. 토큰으로는 애초에 잴 수 없었습니다.
자가진단
- 가설을 세운 뒤, 이미 갖고 있는 데이터 중 그것을 반증할 수 있는 것을 찾아본 적이 있습니까?
- 같은 코드베이스에서 갈라진 변종이 있습니까? 그게 공짜 대조군입니다.
- 효과를 잴 지표가 그 변화를 물리적으로 관측할 수 있는지 확인했습니까?
솔직한 부분
수정 자체는 나쁘지 않습니다. 앱이 먼저 인사하는 게 이 사용자층에 낫다는 판단은 지금도 유효하다고 봅니다.
틀린 건 순서입니다. 저는 원인을 확정하기 전에 수정을 출하했고, 확정하러 갔더니 반증이 나왔습니다. 테스트는 통과했는데 버튼이 아무것도 안 하던 일과 방향은 반대지만 뿌리는 같습니다 — 검증 단계를 건너뛴 자리에서 문제가 생깁니다.
당신의 다음 수정을 출하하기 전에, 그 가설을 반증할 수 있는 표본이 이미 DB에 있는지 한 번만 물어보세요.