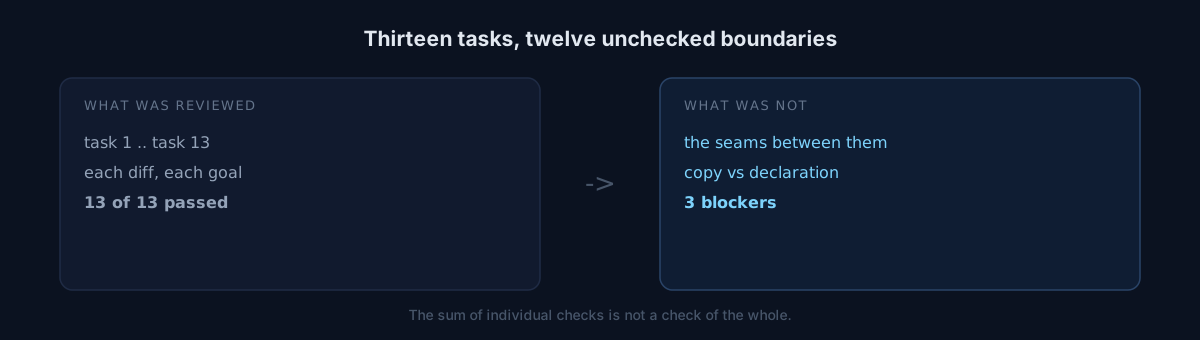
앱 하나를 13개 태스크로 쪼개서 만들었습니다. 각 태스크가 끝날 때마다 코드 리뷰를 한 번씩 돌렸습니다. 13번 전부 통과했습니다.
출시 직전에 습관적으로 전체 리뷰를 한 번 더 돌렸습니다. 블로커 3건이 나왔습니다.
당신의 리뷰는 무엇을 단위로 봅니까?
결함이 있던 자리
세 건 다 단일 태스크 안에서는 옳았습니다.
한 태스크가 스토어 설명을 썼습니다. 그 설명은 잘 읽혔고 15개 언어로 번역됐습니다. 통과.
다른 태스크가 데이터 안전 선언을 채웠습니다. 그 선언은 정확했습니다. 통과.
두 문서가 서로 반대를 말한다는 건 어느 태스크의 범위도 아니었습니다.
나머지 둘도 같은 모양입니다. 기능 설명을 쓴 태스크와 그 기능을 구현한 태스크가 달랐고, 권한 개수를 적은 태스크와 결제 SDK를 붙인 태스크가 달랐습니다.
이게 우연이 아닌 이유
태스크를 쪼개면 각 리뷰의 맥락도 같이 쪼개집니다. 리뷰어는 그 태스크의 diff와 목표를 봅니다. 앞 태스크가 세운 전제가 뒤 태스크에서 무너졌는지는 그 시야에 없습니다.
그리고 작업을 잘게 쪼갤수록 이 경계가 많아집니다. 13개 태스크면 경계가 12개입니다.
여기서 선택이 갈립니다
대응은 둘입니다. 태스크를 더 크게 잡아 경계를 줄이거나, 경계를 보는 리뷰를 따로 두거나.
당신이라면?
저는 후자를 골랐습니다. 태스크를 크게 잡으면 리뷰 품질이 떨어지고 되돌리기도 어려워집니다. 대신 출시 직전 전체 리뷰를 절차에 고정했습니다.
비용은 리뷰 한 번이고, 이번에 그게 블로커 3건을 잡았습니다.
자체 감사도 같은 구멍이 있었습니다
전체 리뷰를 돌리기 전에 제가 직접 출시 판정 감사를 했습니다. 유닛 테스트, 정적 분석, 번들 검증까지 보고 "코드 GO"를 냈습니다.
그 감사에서 제가 기기 데이터베이스를 더럽혔고 계측 스위트가 빨간 상태로 남았습니다. 감사는 계측을 한 번도 다시 돌리지 않았습니다. 유닛만 보고 GO를 낸 겁니다.
그래서 규칙을 하나 더 적었습니다.
유닛과 정적 분석만으로는 "코드 GO"를 말할 수 없다. 계측을 포함하고, 문구와 선언을 한 표에 놓고 봐야 한다.
자가진단
- 작업을 N개로 쪼갰다면, N−1개의 경계를 보는 검사가 있습니까?
- 앞 단계가 세운 전제를 뒤 단계가 바꿨을 때, 그걸 잡는 단계가 절차 안에 있습니까?
- 출시 판정에 쓰는 게이트가 코드 밖 산출물(문구·폼·설정·스토어 자산)까지 덮습니까?
솔직한 부분
전체 리뷰를 돌린 건 습관이었지 설계가 아니었습니다. 안 돌렸으면 셋 다 그대로 나갔을 것이고, 그중 하나는 사용자에게 거짓을 말하는 문장이었습니다.
그리고 이건 이번이 처음이 아닙니다. 앱마다 다 통과했는데 전부 실패했던 일이 같은 계열입니다. 개별 검사의 합은 전체 검사가 아닙니다.
당신의 마지막 기능을 몇 개 단위로 쪼갰는지 세어보고, 그 사이를 본 검사가 몇 개였는지 세어보세요. 저는 13 대 1이었습니다.